नेपाली भाषा बुझ्ने र बोल्ने कृत्रिम बुद्धिमत्ता प्रणाली विकास गर्ने अनुसन्धान त्रिभुवन विश्वविद्यालयमा अघि बढेको छ। कम्प्युटर विज्ञान विभागका अनुसन्धानकर्ताहरूको टोलीले वाक् पहिचान र स्वचालित अनुवादका लागि ठूलो परिमाणमा तथ्यांक संकलन गरिरहेको छ।
अनुसन्धान टोलीका प्रमुख डा. मनोज शर्माका अनुसार विश्वका ठूला भाषिक मोडलहरूमा नेपाली भाषाको तथ्यांक अत्यन्त कम छ। यसैले तिनले नेपाली वाक्य बुझ्ने क्रममा धेरै गल्ती गर्छन्।
विविध लवजको संकलन
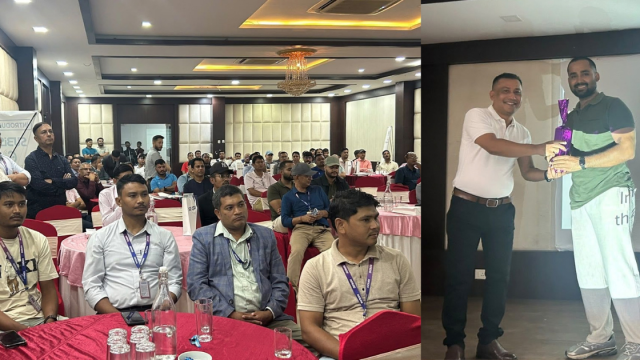
टोलीले देशका विभिन्न भेगका वक्ताबाट करिब दुई हजार घण्टाको आवाज संकलन गर्ने लक्ष्य राखेको छ। पूर्वी पहाड, तराई, सुदूरपश्चिम र काठमाडौं उपत्यकाका वक्ताको बोलीमा हुने भिन्नतालाई समेट्न स्वयंसेवक विद्यार्थीहरू गाउँ–गाउँ पुगेका छन्।
एआईले एउटै लवज मात्र बुझ्यो भने त्यो सबै नेपालीका लागि उपयोगी हुँदैन। हामी विविधतालाई नै आधार बनाउन चाहन्छौं। — डा. मनोज शर्मा
खुला तथ्यांक, व्यावहारिक प्रयोग
संकलित तथ्यांक खुला स्रोतमा राखिने अनुसन्धानकर्ताले जनाएका छन्। यसले देशभित्रका अन्य विश्वविद्यालय र स्टार्टअपलाई पनि नेपाली भाषाका उपकरण बनाउन सहयोग पुग्नेछ।
पहिलो चरणमा यो प्रविधि कृषि र स्वास्थ्य सूचना सेवामा प्रयोग गर्ने योजना छ। उदाहरणका लागि, पढ्न नजान्ने किसानले फोनमा बोलेरै मौसम वा बालीरोगबारे जानकारी लिन सक्नेछन्।
प्रविधिविद्हरूले भने तथ्यांक संकलनमा सहभागीको गोपनीयता र सहमतिको विषयमा विशेष सतर्कता अपनाउनुपर्ने सुझाव दिएका छन्। अनुसन्धान टोलीले प्रत्येक सहभागीबाट लिखित सहमति लिने गरेको जनाएको छ।




प्रतिक्रियाहरू
कृपया सभ्य र मर्यादित भाषामा प्रतिक्रिया दिनुहोस्। अपमानजनक, मानहानिकारक वा घृणा फैलाउने प्रतिक्रियाहरू हटाइनेछन्।
अहिलेसम्म कुनै प्रतिक्रिया छैन। आफ्नो विचार राख्ने पहिलो व्यक्ति बन्नुहोस्।